数据来源与采集
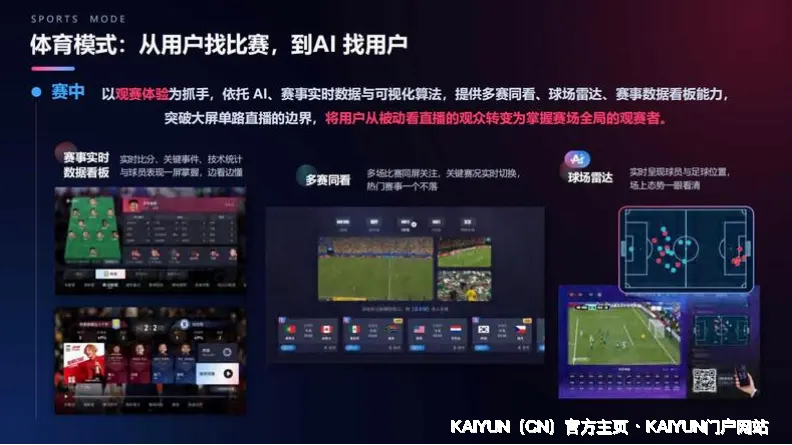
KAIYUN的数据底座由三类来源构成:一是全球主流联赛与杯赛的官方技术统计、赛程与结果信息;二是多家持牌数据商的实时赔率快照,按分钟级采样并完整留存变动轨迹;三是自有采集节点对阵容、伤停、轮换、天气与赛程密度等结构性变量的持续跟踪。所有原始数据入库前需经过去重、时区对齐、缺失值插补与异常值标记,最终形成可回溯的时间序列底表,确保后续建模建立在一致且可复现的数据口径之上,避免因口径漂移导致结论失真。
多源数据与量化模型,输出可验证的赛前分析参考
KAIYUN的数据底座由三类来源构成:一是全球主流联赛与杯赛的官方技术统计、赛程与结果信息;二是多家持牌数据商的实时赔率快照,按分钟级采样并完整留存变动轨迹;三是自有采集节点对阵容、伤停、轮换、天气与赛程密度等结构性变量的持续跟踪。所有原始数据入库前需经过去重、时区对齐、缺失值插补与异常值标记,最终形成可回溯的时间序列底表,确保后续建模建立在一致且可复现的数据口径之上,避免因口径漂移导致结论失真。
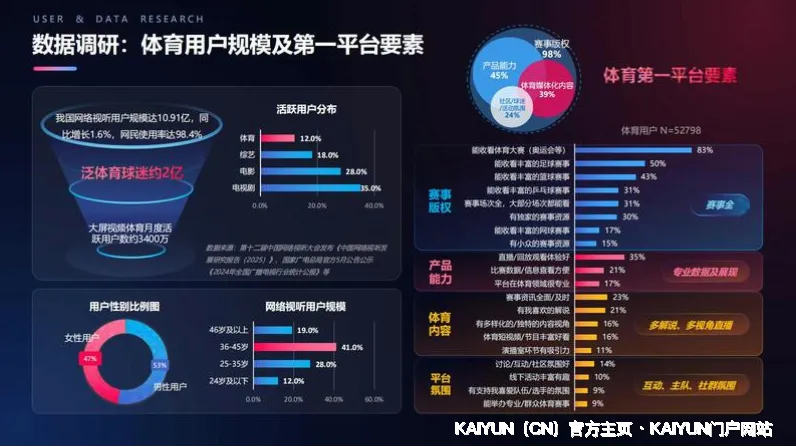
在建模层面,kaiyun采用“特征工程+多模型集成”的路径:先将赔率变动速率、盘口偏移幅度、历史交锋、近期攻防效率与休息天数等转换为标准化特征,再以梯度提升树处理胜平负分类,以泊松比分模型刻画进球分布,最后通过等渗回归等概率校准方法修正输出,抑制模型过度自信。评估环节采用时间序列交叉验证与滚动回测,严格隔离训练期与检验期,杜绝未来信息泄漏,力求概率输出与实际发生频率在长期样本中保持吻合。
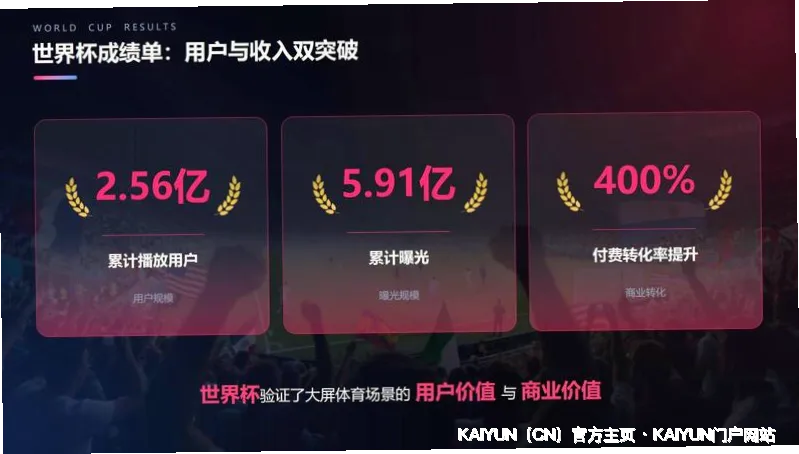
我们以滚动窗口公开展示历史表现:按月统计胜平负方向与大小球方向的命中率、按平均赔率折算的回报水平,以及最大连续偏差区间,并明确标注样本量与统计口径,便于用户自行复核。需要强调,命中率是概率模型的历史结果,不等于单场保证;高赔率选项本身波动更大,短期样本的参考价值有限。建议以半年以上的长期视角观察模型稳定性,而非以阶段性连胜或连败判断优劣,这也是KAIYUN坚持披露完整回测数据的初衷。
使用建议:先核对数据更新时间戳与样本量,再对照模型概率与市场赔率寻找偏差区间,而非盲从单一结论;重点关注伤停、轮换与赛程密度等信息的时效性,临场变动往往触发概率重估。阅读命中率时需区分方向命中与回报水平,两者并不等价。请将本页内容视为信息分析工具而非决策依据,任何选择都应基于自身判断与合理的资金管理,量力而行、理性看待波动。KAIYUN不提供任何形式的收益承诺,也不对使用结果承担责任。
KAIYUN数据服务专题页聚焦赔率分析的方法论本身:我们从哪些渠道采集数据、如何清洗与对齐口径、用什么模型把赔率变动转化为可解释的概率输出,以及这些概率在历史样本中的真实表现。本页不提供任何比赛推荐,而是把建模流程、回测口径与命中率统计完整摊开,帮助kaiyun用户理解一组数字从采集到结论的全过程,从而更理性地使用数据工具。
了解更多赔率数据服务,请联系我们
返回首页